Реализация RAG
Чему научитесь
Видео 5:12 и текст урока
К концу урока вы сможете:
- реализовать пять шагов RAG в коде;
- объяснить, зачем хранить исходный текст рядом с эмбеддингом;
- читать результаты поиска по косинусному расстоянию.
Видео и текст урока.
Смотреть урок на Skilljar Implementing the RAG flow · 5:12Поток RAG понятен концептуально — реализуем его шаг за шагом. Разберём полный пример: разбиваем текст, генерируем эмбеддинги, сохраняем их в векторную базу и ищем по сходству.
Пять шагов реализации RAG
Реализация повторяет пять шагов, о которых шла речь раньше:
- разбить текст по разделам;
- сгенерировать эмбеддинг для каждого фрагмента;
- создать векторное хранилище и добавить в него каждый эмбеддинг;
- сгенерировать эмбеддинг вопроса пользователя;
- найти в хранилище самые подходящие фрагменты.
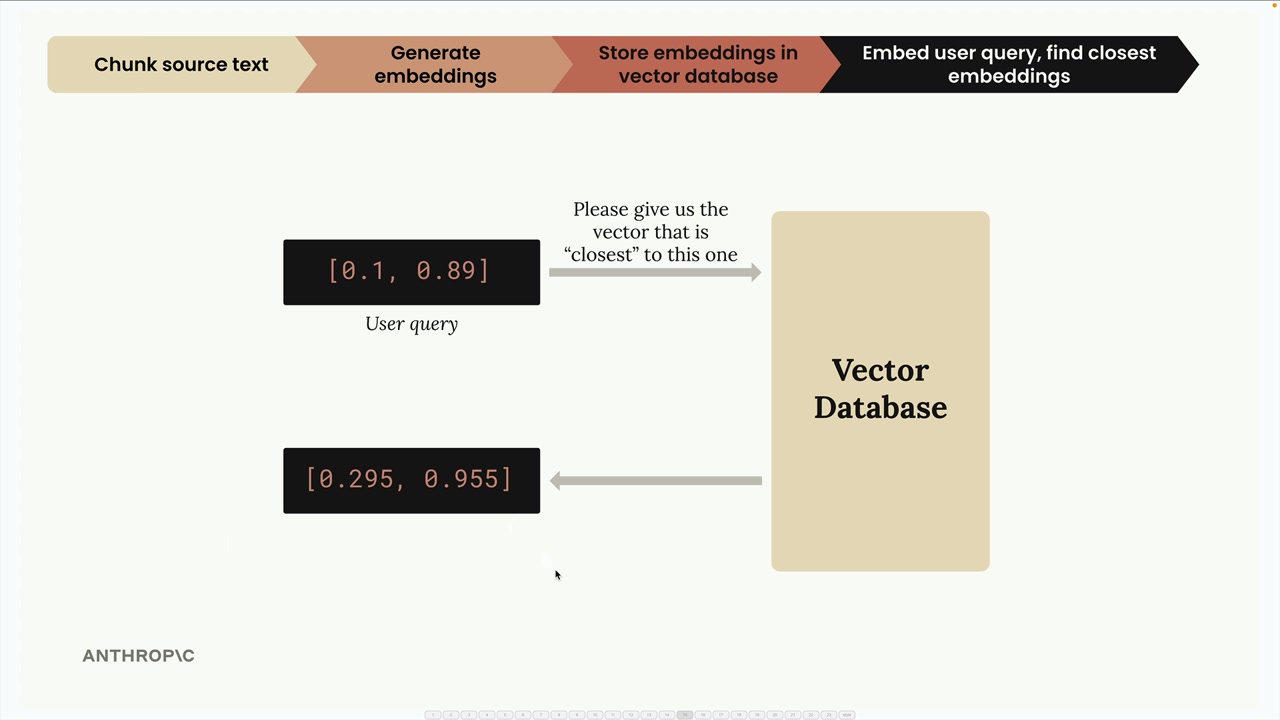
Схема показывает, как вопросы пользователей превращаются в эмбеддинги и как по векторной базе ищется самое подходящее содержимое.
Шаг 1. Разбиваем текст
Сначала загружаем документ и делим его на удобные разделы:
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
chunks[2]  # Test to see the table of contents
Используем ту же функцию chunk_by_section, что и раньше, чтобы разделить документ на логические разделы.
Шаг 2. Генерируем эмбеддинги
Затем создаём эмбеддинги для всех фрагментов сразу:
embeddings = generate_embedding(chunks)
Функция эмбеддингов доработана: она принимает и одну строку, и список строк, так что пакетная обработка эффективнее.
Шаг 3. Сохраняем в векторную базу
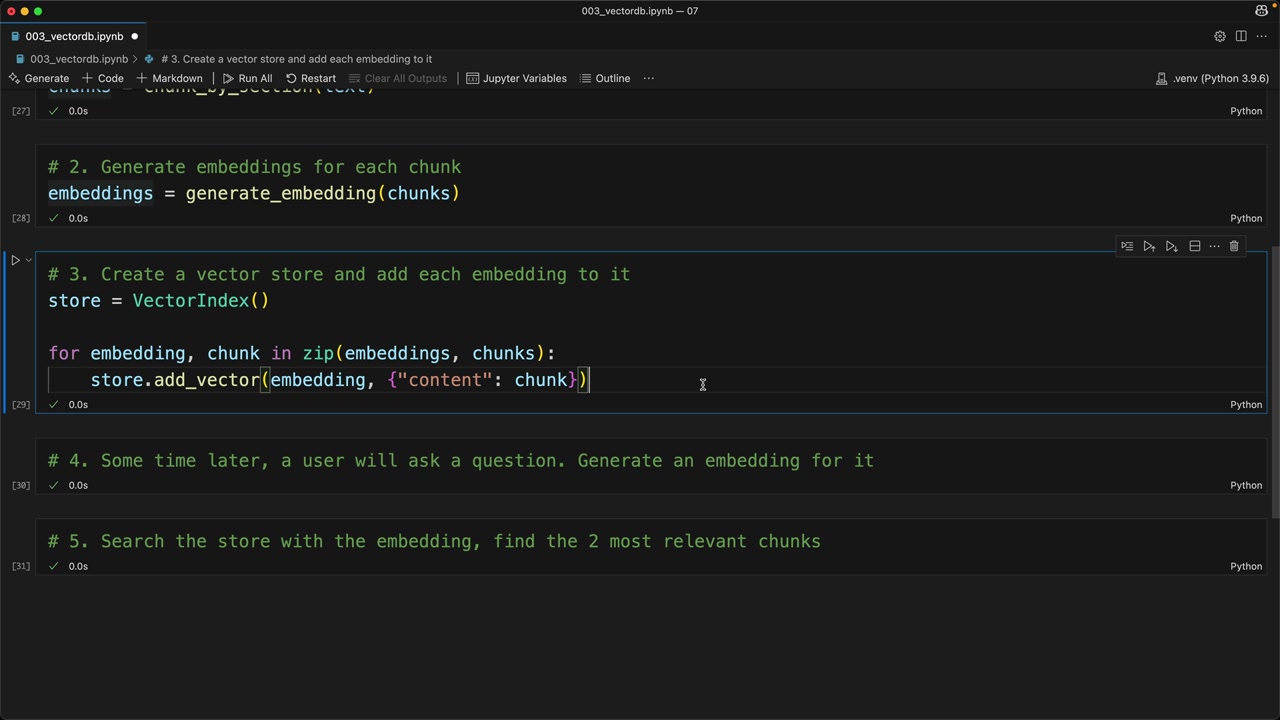
Теперь создаём векторное хранилище и заполняем его эмбеддингами вместе с соответствующим текстом:
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
Обратите внимание: мы храним и эмбеддинг, и исходный текст. Это важно: при поиске нам нужно вернуть сам текст, а не только числовой эмбеддинг.
Зачем хранить исходный текст
Если в ответ на запрос к векторной базе получить только числа эмбеддинга, толку от них мало. Нужен сам текст, из которого эти эмбеддинги получены. Поэтому рядом с каждым эмбеддингом в базе хранится исходный текст фрагмента (или хотя бы ссылка на него).
Шаг 4. Обрабатываем вопрос пользователя
Когда пользователь задаёт вопрос, генерируем эмбеддинг вопроса:
user_embedding = generate_embedding("What did the software engineering dept do last year?")
Шаг 5. Находим подходящее содержимое
Наконец, ищем в векторном хранилище самые похожие фрагменты:
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
Поиск возвращает два самых подходящих фрагмента вместе с оценками сходства (косинусными расстояниями).
Результаты поиска показывают, какие разделы документа ближе всего к вопросу, вместе с оценками сходства.
Что получилось
На наш пример — вопрос об отделе разработки ПО — приходит:
- Section 2: Software Engineering с расстоянием 0.71 (самое близкое);
- раздел Methodology с расстоянием 0.72 (второе).
Чем меньше расстояние, тем выше сходство, поэтому Section 2 — самый подходящий к вопросу раздел.
Что дальше
Эта реализация хорошо работает в простых случаях, но бывают ситуации, где она ведёт себя не так, как ожидалось. В следующих уроках разберём улучшения, которые делают систему RAG надёжнее и точнее.
Главное: RAG — это перевод текста в числа (эмбеддинги), эффективное хранение этих чисел и поиск подходящего содержимого по математическому сходству, когда пользователь задаёт вопрос.
Дальше
Следующий урок — лексический поиск BM25: он находит точные совпадения терминов, которые семантический поиск пропускает.
Оригинал урока: Implementing the RAG flow.